El HASH De Una Mentira
El hash de una mentira: cuando una imagen íntegra representa algo que nunca ocurrió
Hasta ahora, en informática forense, hemos analizado imágenes para después acreditar (mediante sus metadatos, etc.) que no ha sido manipulada, desde que se generó. Esta imagen puede que estuviera perfectamente almacenada en un móvil, o encontrarse en un equipo y haberla adquirido correctamente. Una vez exportada con garantías, se suele calcular su HASH y conservarse con una cadena de custodia impecable. Sin embargo, debemos pensar ya más allá, pues la imagen podría mostrar una escena que jamás existió.
Esta posibilidad nos obliga a revisar cómo explicamos los resultados de una investigación forense. La inteligencia artificial no ha dejado obsoletos los hashes ni los procedimientos de adquisición. Muy al contrario, ha hecho más urgente una distinción que siempre debió acompañarnos: conservar un archivo y demostrar la realidad de lo que representa son tareas diferentes.
Así pues, la pregunta ya no puede terminar en «¿se ha modificado este archivo?». También debemos preguntarnos de dónde procede, cómo se creó y qué elementos permiten sostener que ocurrió lo que vemos.
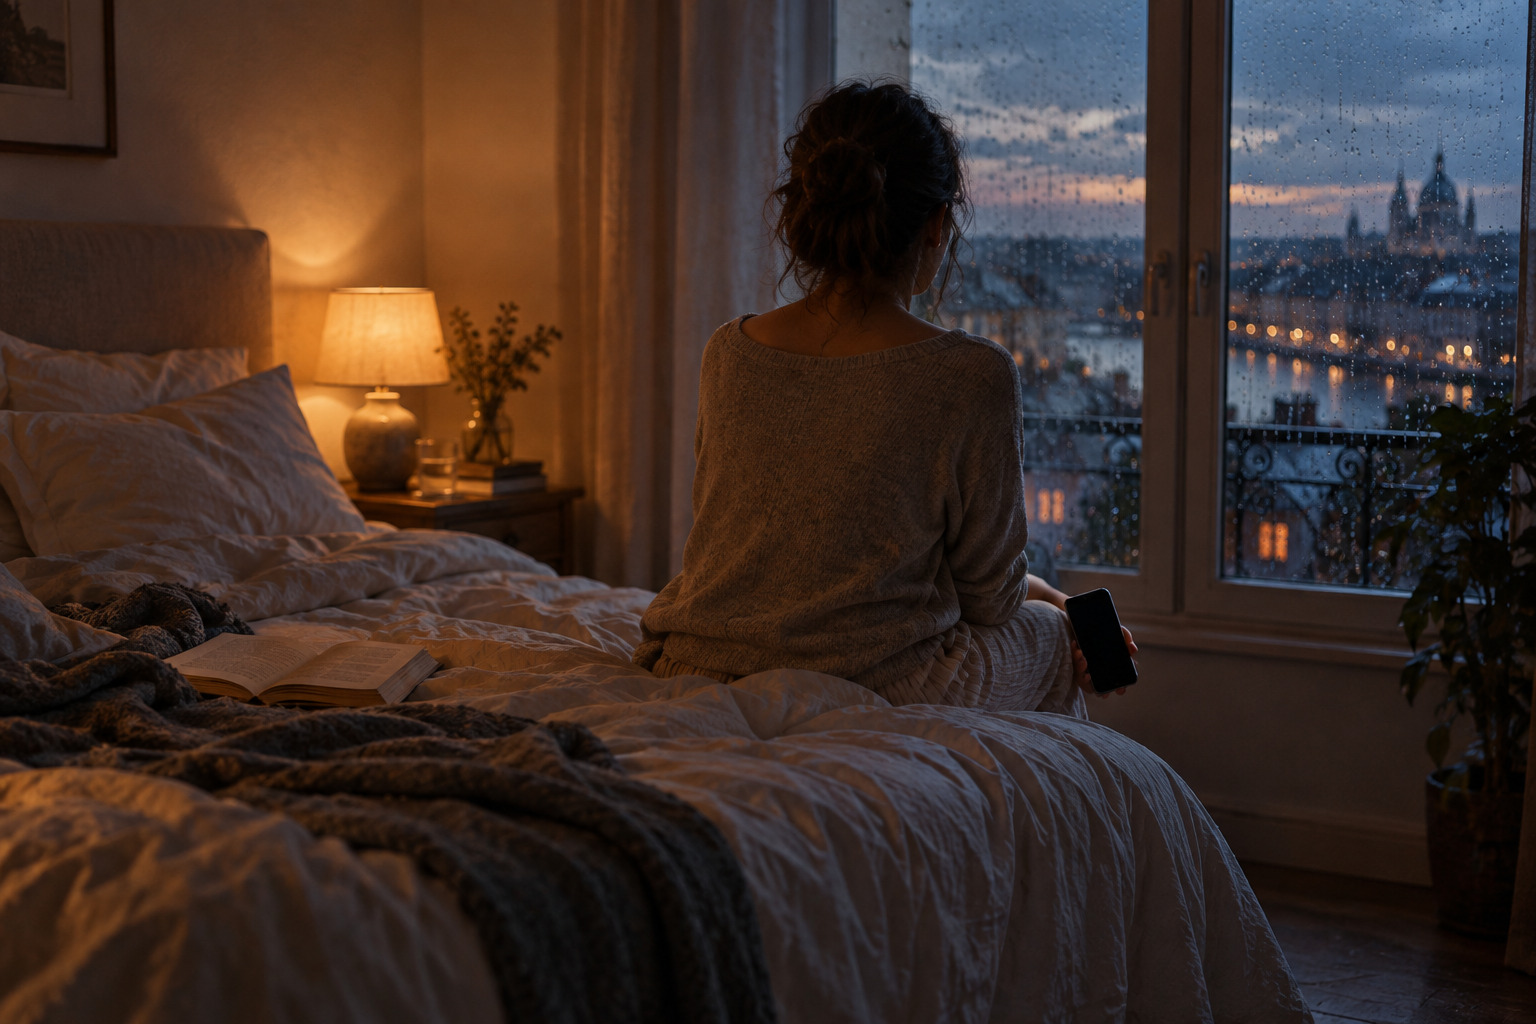
Podemos -sin saberlo- preservar perfectamente una falsificación
Imaginemos una fotografía en la que una persona está sentada en la cama, mirando el horizonte a través de su ventana. La imagen aparece en un ordenador que se somete a una adquisición forense. Documentamos el procedimiento, calculamos los hashes y verificamos la copia de trabajo. Todo coincide.
Hasta aquí, el trabajo puede ser técnicamente correcto. El problema comienza si, apoyándonos en esas comprobaciones, podemos afirmar que esa escena ocurrió realmente.
El hash, por sí solo, no responde ya a esa pregunta. Permite comprobar la coincidencia entre el archivo examinado y una referencia, dentro de las condiciones del procedimiento utilizado. Sin embargo,no examina el significado de los píxeles ni determina cómo se originó la escena.
Si la imagen se generó con inteligencia artificial antes de incorporarse al ordenador, podemos adquirirla y custodiarla sin que cambie un solo byte. Además, el desconocimiento respecto a la falsedad del acontecimiento representado es anterior a nuestra intervención.
No hace falta romper la criptografía ni alterar la evidencia durante el análisis. Podemos preservar una falsificación con el mismo rigor con el que preservaríamos una fotografía de un hecho real.
La cadena de custodia -en todo caso- sigue siendo necesaria. Lo que debemos evitar es atribuirle una función que no cumple: transformar en verdadero el contenido del objeto custodiado.
Cuatro preguntas que conviene separar
En una investigación (yo, al menos) suelo formularme cuatro cuestiones que no deberían confundirse.
La primera es la integridad: ¿el archivo que analizo coincide con el que adquirí o con una referencia fiable?
La segunda es la procedencia: ¿qué sabemos de su creación y del recorrido que siguió hasta llegar al lugar donde lo encontramos?
La tercera es la atribución: ¿quién lo creó, capturó o envió y quién aparece realmente en él? Encontrar una imagen en un equipo no identifica automáticamente a su autor. Reconocer un rostro o escuchar una voz tampoco resuelve por sí solo la identidad de la persona representada.
La cuarta es la correspondencia con los hechos: ¿ocurrió la escena en el lugar, momento y circunstancias que se alegan?
Estas preguntas pueden tener respuestas distintas. Podemos acreditar con solidez la integridad de un archivo y disponer de muy poca información sobre su origen. También podemos conocer el dispositivo de captura sin poder confirmar el contexto que acompaña a la imagen.
Las escenificaciones y las imágenes descontextualizadas existían mucho antes de la IA generativa. Lo que cambia es la facilidad para producir representaciones convincentes y utilizarlas para atribuir a alguien acciones que nunca realizó.
Una fotografía real también puede fotografiar una falsedad
Hay un ejemplo que ayuda a comprender hasta dónde llega el problema. Pensemos en una escena sintética mostrada en una pantalla. Después, alguien fotografía esa pantalla con una cámara.
La nueva fotografía procede de una captura real. Según las condiciones, puede conservar metadatos y características compatibles con el dispositivo utilizado. Sin embargo, el acontecimiento que parece mostrar continúa sin haber ocurrido.
El dispositivo fotografió algo que existía delante de su objetivo: una pantalla con una imagen. Eso no equivale a haber presenciado la escena representada dentro de ella.
Por eso, cuando utilizamos la palabra «auténtica», necesitamos explicar a qué nos referimos. ¿Estamos hablando del archivo, del proceso de captura, de la identidad del sujeto o del acontecimiento? Una conclusión que no distingue estos planos puede inducir a error, aunque las comprobaciones técnicas sean correctas.
C2PA aporta procedencia, pero no certifica la realidad
En este contexto aparece C2PA, un estándar pensado para vincular al contenido digital declaraciones de procedencia mediante mecanismos criptográficos. Sus credenciales pueden aportar información sobre el origen declarado, las herramientas utilizadas o determinadas operaciones de edición.
Es una aportación útil. Permite examinar información que de otro modo podría quedar sin documentar. Pero (al igual que ocurre con el HASH) no debemos convertir una credencial verificable en un certificado universal de veracidad.
La documentación de C2PA explica que la procedencia, por sí sola, no determina si el contenido es verdadero, exacto o factual. También contempla mecanismos para intentar recuperar credenciales separadas del archivo mediante marcas o huellas y sistemas de búsqueda. Su disponibilidad depende de la implementación.
Conviene distinguir la validación de estas credenciales de la detección de imágenes sintéticas. La primera verifica información vinculada al contenido. La segunda intenta inferir cómo se produjo, incluso cuando esa información no está disponible. Una etiqueta de una red social es, además, el resultado visible de las reglas que esa plataforma aplica.
Son procesos relacionados, pero no intercambiables.
Mi prueba: la imagen seguía siendo IA, pero desaparecía la advertencia
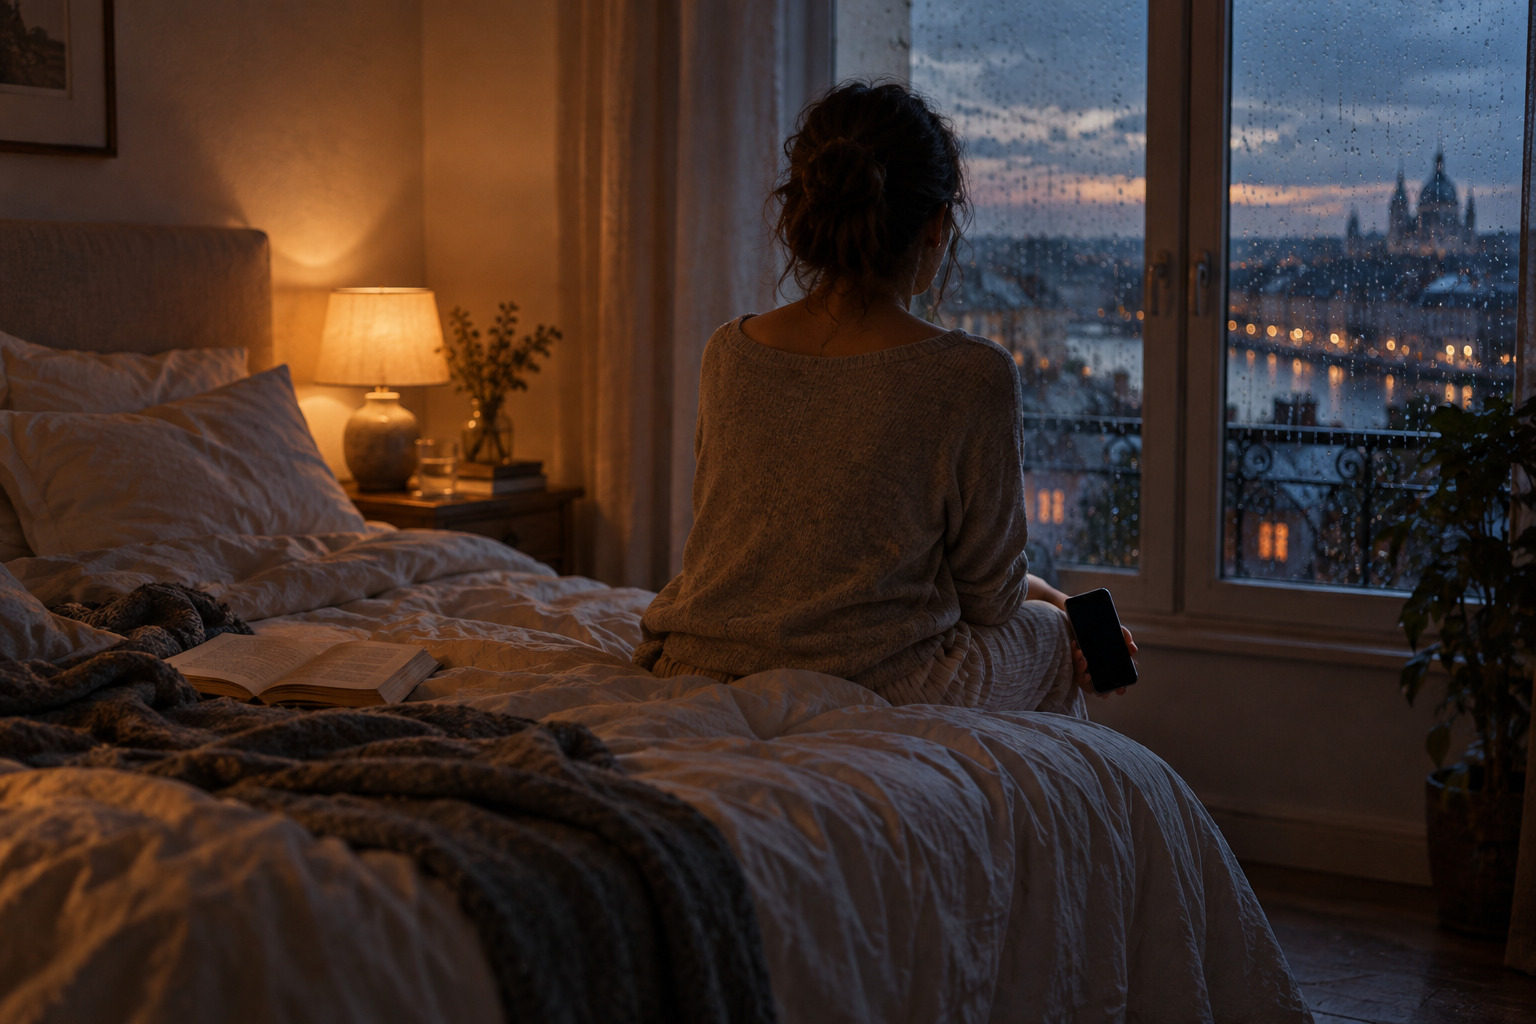
En pruebas que he realizado, he observado que, después de convertir una imagen generada con IA de JPG a PNG (por ejemplo) y subir la versión resultante a Facebook, Instagram, X, etc., dejaba de mostrarse el etiquetado que advertía sobre su origen artificial. De hecho, las dos imágenes incluidas en este artículo, representan la misma escena. Si descargáis ambas y las subís a Facebook, por ejemplo, os dirá que una de ellas está hecha con IA. No os diré cuál.
Pero la verdad es que el contenido de ambas fotos seguía siendo sintético. La conversión no ha transformado la escena en un hecho real. Lo único que ha cambiado es la advertencia que recibe quien la ve.
Es decir: una imagen de origen artificial puede -perfectamente- presentarse sin la misma advertencia visible y, por tanto, pasar por auténtica.
Una explicación compatible con ese resultado es que la conversión no conservara la información que activaba el etiquetado. Meta, Instagram, X…, todos utilizan, entre otras señales, información de los estándares C2PA e IPTC. También reconoce que los marcadores pueden eliminarse y que no es posible identificar todo el contenido generado por IA.
La consecuencia práctica puede ser igual de preocupante: el contenido conserva su capacidad de engañar mientras desaparece la señal que advertía sobre su procedencia.
Con esto quiero deciros que no debemos interpretar la ausencia de una advertencia, como una comprobación superada.
Una imagen sin etiqueta puede ser una fotografía convencional. También puede ser contenido sintético que nunca incorporó credenciales, que las perdió durante su transformación o cuya procedencia no pudo establecer la plataforma. La mera ausencia de información no permite elegir automáticamente entre esas posibilidades.
Del mismo modo, encontrar una credencial exige leer qué declara, quién la firma y qué alcance tiene la validación. No basta con mostrar un icono y dar por resueltas todas las preguntas.
Como peritos, debemos resistirnos a convertir «no se ha encontrado una señal de IA» en «se ha demostrado que no es IA». Son afirmaciones distintas.
Tampoco sería razonable recorrer el camino contrario y sospechar de toda imagen que no lleve credenciales. La fotografía legítima no depende de que todas las cámaras, aplicaciones y plataformas hayan participado en un mismo sistema de procedencia.
Los detectores tampoco sustituyen el razonamiento pericial
La alternativa no consiste en delegar toda la decisión en un detector automático. Sus resultados deben valorarse conociendo la herramienta, su versión, las condiciones de evaluación y las características del material examinado.
Una puntuación no puede interpretarse automáticamente como la probabilidad de que el hecho representado sea falso. Antes habría que saber qué mide, con qué errores y hasta qué punto su evaluación se parece al caso concreto.
NIST estudia la procedencia, el marcado y la detección como enfoques para abordar el contenido sintético. Para el trabajo pericial, la consecuencia es que debemos valorar varias fuentes de información y explicar qué aporta cada una.
Y aquí llega la gran pregunta: ¿Qué debemos cambiar en el examen forense?
La primera tarea debería ser concretar el hecho que se pretende acreditar. «Analizar un vídeo» es demasiado amplio si lo que se discute es que una persona estuvo en un lugar, pronunció una frase o autorizó una operación.
Después debemos conservar la evidencia con rigor e investigar, en la medida de lo posible, lo sucedido antes de adquirirla: fuente, dispositivo, aplicaciones, versiones previas y recorrido del contenido.
El análisis debería contemplar hipótesis alternativas razonables: captura directa, edición, generación sintética, reproducción de una pantalla, escenificación o presentación fuera de contexto. No todas tendrán el mismo apoyo, pero es necesario contrastar todas aquellas que puedan cambiar la conclusión.
La corroboración independiente resulta esencial. Diez publicaciones de una misma imagen pueden derivar de un único archivo. Su repetición no equivale a diez confirmaciones del acontecimiento. Debemos buscar registros y fuentes con un origen realmente distinto y valorar qué hecho acredita cada uno.
También debemos cuidar la redacción. «El archivo coincide con el adquirido» puede ser una conclusión bien fundada. «El hecho mostrado ocurrió» requiere un respaldo adicional. Si no podemos determinar el origen o descartar determinadas alternativas, el informe debe reflejarlo con claridad.
Podemos terminar una adquisición con hashes coincidentes, una copia verificada y una cadena de custodia documentada. Ninguna de esas garantías pierde su valor por la aparición de la inteligencia artificial.
Lo que cambia es la atención que debemos prestar al origen del contenido y al razonamiento que conecta el archivo con el hecho investigado. Una credencial, una etiqueta o un detector pueden aportar información, pero ninguna de estas piezas debe convertirse, por comodidad, en una respuesta para todo.
Nuestra responsabilidad consiste en explicar qué hemos comprobado, qué inferimos y qué permanece sin resolver.
El hash puede ser correcto. La escena puede no haber existido nunca.
José Aurelio García
Auditor y Perito Informático-Perito en Piratería Industrial e Intelectual-Informático Forense
Creador y profesor del MOOC OnLine «Ciberseguridad Defensiva, Ofensiva y OSINT» impartido por la Univ. de Extremadura
Profesor en el «Máster de Abogacía Digital», impartido por la USAL
Profesor en el «Grado en Ciencias Policiales», impartido por la USAL para Policía Nacional.
Socio Fundador Asociación Nacional de Ciberseguridad y Pericia Tecnológica – ANCITE
Prueba Electrónica – El Blog de Auditores y Peritos Informáticos
No hay comentarios